En este artículo
- Resumen ejecutivo
- Matriz principal: local vs cloud
- DGX Spark: capacidad/precio
- RTX 5090: velocidad para ≤32B
- RTX PRO 6000: producción 70B
- DeepSeek 70B: tres estrategias
- Multi-GPU local vs cloud
- Break-even: utilización real
- TCO a cinco años
- Arquitectura híbrida recomendada
- Ranking final
- Preguntas frecuentes
En el artículo anterior analizamos cuánto cuesta ejecutar DeepSeek en la nube. Pero existe un punto a partir del cual el cloud deja de ser económico. Este artículo estudia cuándo compensa comprar el hardware.
Conclusión principal: con carga ocasional suele ganar la API o el cloud bajo demanda. Con cargas sostenidas, privacidad y uso diario, el hardware local puede reducir el TCO entre un 50% y un 80% frente a mantener GPUs cloud durante 3-5 años.
Resumen ejecutivo
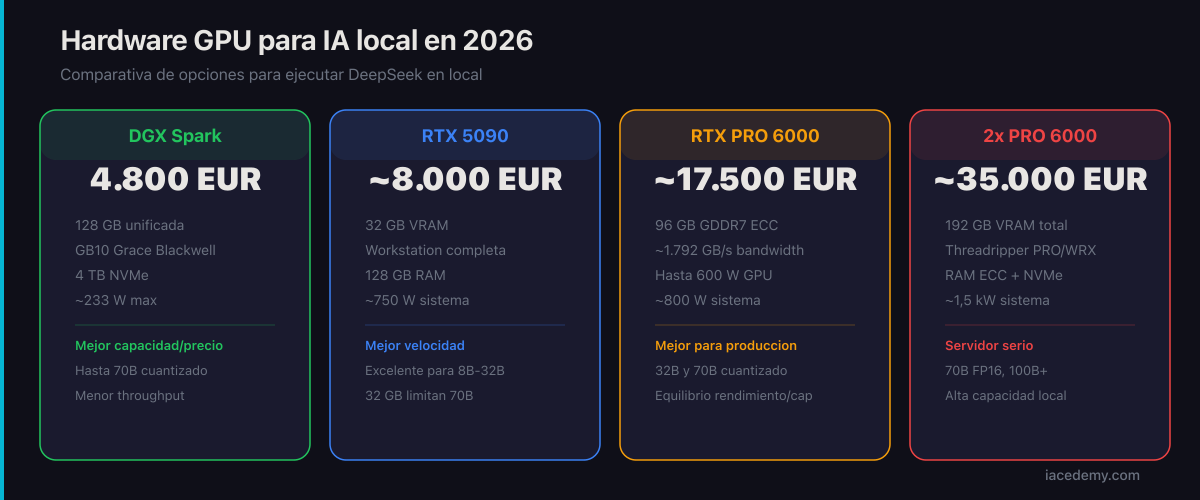
Los cuatro candidatos principales para IA local en 2026:
| Hardware | CAPEX | Memoria | Consumo | Mejor para |
|---|---|---|---|---|
| DGX Spark MEJOR CAPACIDAD/PRECIO | 4.800 € | 128 GB unificada | ~233 W | Capacidad/precio, laboratorio |
| Workstation RTX 5090 | ~8.000 € | 32 GB VRAM | ~750 W | Velocidad para ≤32B |
| RTX PRO 6000 | ~17.500 € | 96 GB GDDR7 ECC | ~800 W | Producción 32B y 70B |
| 2× RTX PRO 6000 | ~35.000 € | 192 GB total | ~1,5 kW | 70B FP16, 100B+ |
Matriz principal: hardware local frente a cloud
| Escenario | Hardware | CAPEX | Electricidad/año | TCO 3 años | TCO 5 años |
|---|---|---|---|---|---|
| Básico | DGX Spark | 4.800 € | ~409 € | ~6.458 € | ~7.563 € |
| Rendimiento | RTX 5090 | ~8.000 € | ~1.314 € | ~12.662 € | ~15.770 € |
| Profesional | RTX PRO 6000 | ~17.500 € | ~1.402 € | ~23.280 € | ~27.133 € |
| Multi-GPU | 2× RTX PRO 6000 | ~35.000 € | ~2.628 € | ~46.034 € | ~53.390 € |
| Frontier | DGX Station GB300 | ~90.000 € | ~2.803 € | ~106.510 € | ~117.516 € |
Hipótesis: electricidad a 0,20 EUR/kWh, uso 24×7, mantenimiento ~3% anual. No incluye personal, climatización dedicada, financiación ni IVA.
DGX Spark: el mejor candidato por capacidad/precio
DGX Spark resulta especialmente atractivo para IA local porque combina un coste contenido con 128 GB de memoria unificada, 4 TB NVMe y un consumo máximo cercano a 233 W.
| Carácterística | DGX Spark |
|---|---|
| Precio de referencia | 4.800 € |
| Memoria | 128 GB unificada |
| Almacenamiento | 4 TB NVMe |
| Procesador | GB10 Grace Blackwell |
| Rendimiento IA | Hasta 1 PFLOP FP4 |
| Networking | ConnectX-7 + 10 GbE |
| Consumo máximo | ~233 W |
Importante
«Cabe en memoria» no equivale a «sirve con alto throughput». DGX Spark destaca por capacidad, pero su ancho de banda de memoria es mucho menor que el de una GPU profesional discreta.
RTX 5090: máxima velocidad para modelos ≤32B
Una workstation con RTX 5090 es adecuada cuando el objetivo es latencia y tokens por segundo en modelos de hasta 32B cuantizados.
| Componente | Estimación |
|---|---|
| RTX 5090 32 GB | ~5.500 € |
| CPU + 128 GB RAM | 900-1.300 € |
| Placa + NVMe + PSU + caja | 1.200-1.700 € |
| Total workstation | ~7.500-8.500 € |
Principal limitación: 32 GB de VRAM. Excelente para 8B, 14B y 32B Q4, pero deja poco margen para 70B sin multi-GPU u offload.
El módulo avanzado de IAcademy cubre desde Ollama hasta vLLM en GPU dedicada.
RTX PRO 6000 Blackwell: workstation profesional para 70B
La RTX PRO 6000 ofrece 96 GB de GDDR7 ECC, ~1.792 GB/s de ancho de banda y hasta 600 W de consumo. Probablemente la más equilibrada para DeepSeek 32B y 70B cuantizados con rendimiento cercano a producción.
| Métrica | Valor |
|---|---|
| VRAM | 96 GB GDDR7 ECC |
| Ancho de banda | ~1.792 GB/s |
| Potencia GPU | Hasta 600 W |
| Precio GPU | ~12.100-15.000 € |
| Workstation completa | ~17.000-20.000 € |
DeepSeek 70B: tres estrategias razonables
| Arquitectura | Coste | Memoria | Comentario |
|---|---|---|---|
| DGX Spark | 4.800 € | 128 GB unificada | Muy barato por capacidad, menor throughput |
| RTX PRO 6000 | ~17.500 € | 96 GB | Equilibrio producción/capacidad |
| 2× RTX PRO 6000 | ~35.000 € | 192 GB | Alta capacidad local |
| Cloud H100 | ~2.000 €/mes | 80 GB | Sin CAPEX, flexible |
| Cloud H200 | ~3.000 €/mes | 141 GB | Mayor capacidad y rendimiento |
Multi-GPU local frente a 2× H100 cloud
Un sistema 2× RTX PRO 6000 cuesta ~35.000-38.000 € incluyendo plataforma Threadripper PRO/WRX, RAM ECC, almacenamiento, PSU y refrigeración.
| Período | 2× H100 cloud (~4.800 €/mes) | 2× RTX PRO 6000 local |
|---|---|---|
| 1 año | ~58.000 € | ~35.000-38.000 € + OPEX |
| 3 años | ~174.000 € 3.8x | ~46.000 € TCO |
| 5 años | ~288.000 € 5.4x | ~53.000 € TCO |
A 3 años: el cloud cuesta 3,8x más. A 5 años: 5,4x más. No son configuraciones idénticas en rendimiento absoluto, pero ilustran el impacto económico de carga multi-GPU sostenida.
Descarga la guía maestra de Claude (gratis)
Prompts avanzados, workflows y atajos que no encontrarás en la documentación oficial. PDF directo a tu email.
El factor decisivo: utilización real
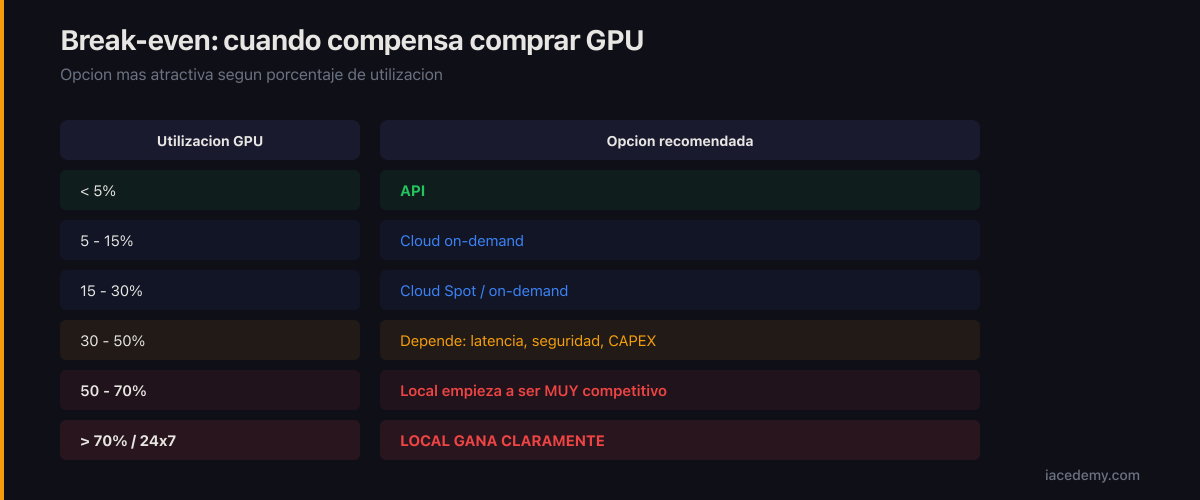
| Utilización GPU | Opción más atractiva |
|---|---|
| < 5% | API |
| 5-15% | Cloud on-demand |
| 15-30% | Cloud Spot / on-demand |
| 30-50% | Depende de latencia, seguridad y CAPEX |
| 50-70% | Local empieza a ser muy competitivo |
| > 70% | Local suele ganar claramente LOCAL GANA |
| 24×7 | Local gana ampliamente LOCAL GANA |
Regla práctica
Si la GPU va a permanecer encendida casi todo el día durante varios años, el CAPEX local merece evaluación seria. Si la carga es esporádica o impredecible, cloud y API conservan una ventaja operativa importante.
TCO a cinco años: la comparación definitiva
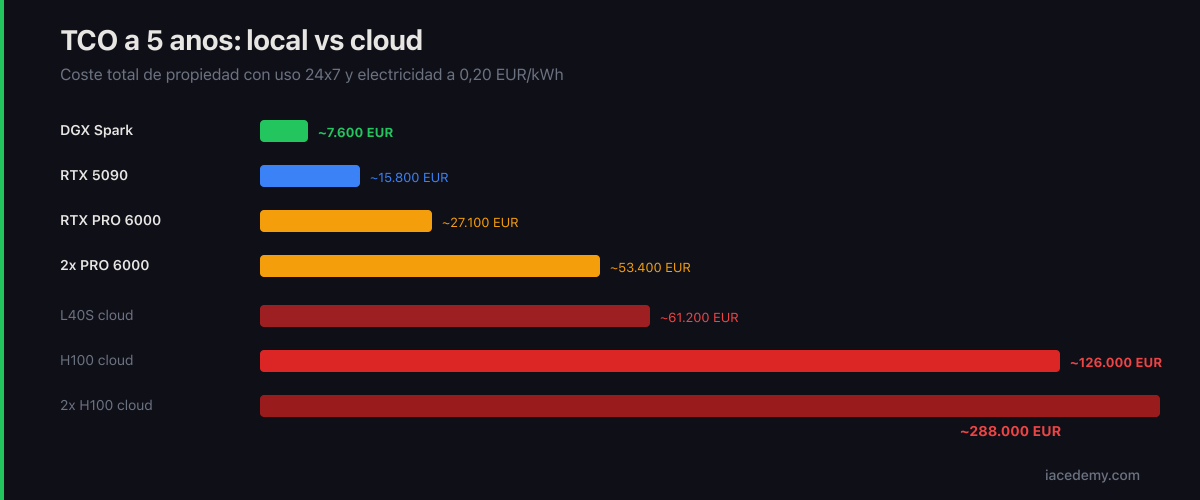
| Arquitectura | TCO a 5 años |
|---|---|
| DGX Spark local | ~7.600 € MEJOR |
| RTX 5090 local | ~15.800 € |
| RTX PRO 6000 local | ~27.100 € |
| 2× RTX PRO 6000 local | ~53.400 € |
| L40S cloud (~1.020 €/mes) | ~61.200 € |
| H100 cloud (~2.100 €/mes) | ~126.000 € 16.5x |
| 2× H100 cloud (~4.800 €/mes) | ~288.000 € 38x |
DGX Spark a 5 años: 7.600 €. H100 cloud a 5 años: 126.000 €. Es 16,5x más caro. Obviamente no son comparaciones directas en rendimiento, pero la diferencia económica es enorme.
Arquitectura híbrida recomendada
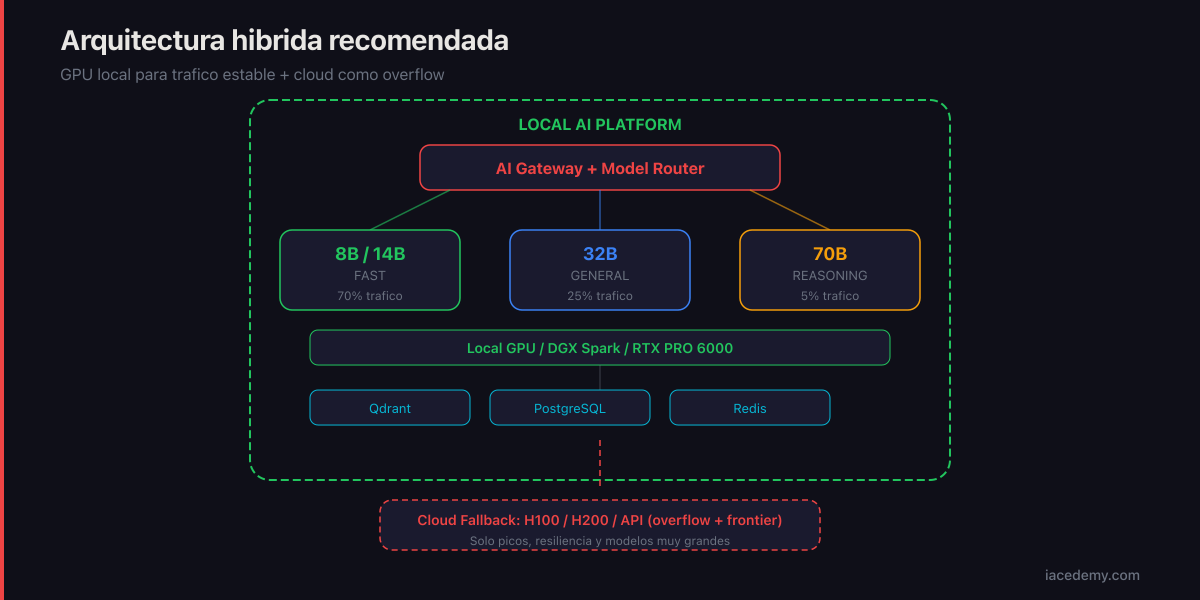
La estrategia más eficiente no suele ser todo local o todo cloud, sino usar local para el tráfico estable y cloud como overflow.
               LOCAL AI PLATFORM
                      │
                 AI Gateway
                      │
                Model Router
                      │
   ┌─────────────────┼─────────────────┐
   │                 │                 │
  FAST             GENERAL          REASONING
 8B / 14B            32B               70B
   │                 │                 │
   └─── Local GPU / DGX / PRO ───┘
                      │
         ┌──────────┼──────────┐
         │          │          │
       Qdrant   PostgreSQL    Redis
                      │
                API / Cloud fallback
                      │
                H100 / H200 / API
Fase 1: comenzar con DGX Spark
Laboratorio, agentes, RAG, 8B/14B/32B y 70B cuantizado. Coste: ~4.800 € + ~34 €/mes de electricidad.
Fase 2: añadir RTX PRO 6000
Cuando aparezca una necesidad real de throughput interactivo y concurrencia.
Fase 3: mantener cloud como overflow
H100/H200 cloud para picos, resiliencia o acceso a modelos frontier. Reduce CAPEX sin renunciar a escalabilidad.
Ranking final
1. DGX Spark: mejor capacidad/precio
4.800 €, 128 GB, consumo reducido. Excelente nodo inicial para IA privada.
2. RTX PRO 6000: mejor workstation profesional
96 GB GDDR7 ECC y mucho más ancho de banda. Adecuada para 70B cuantizado y producción seria.
3. RTX 5090: mejor velocidad para ≤32B
Excelente throughput, pero 32 GB limitan su utilidad para modelos grandes.
4. 2× RTX PRO 6000: servidor serio de inferencia
192 GB de VRAM total. Coste elevado, pero puede reducir drásticamente el TCO frente a cloud multi-GPU continuo.
Conclusión
Para uso ocasional, la API sigue siendo lo más racional. Para cargas moderadas e impredecibles, cloud on-demand conserva ventaja. Pero cuando el uso es intensivo, estable y sensible, comprar hardware puede reducir el coste total entre un 50% y un 80% frente a mantener GPUs cloud durante 3-5 años.
Recomendación: comenzar con un nodo local de alta capacidad, medir utilización real y añadir GPU profesional cuando los datos de throughput lo justifiquen. Mantener cloud como capa elástica de overflow.
Preguntas frecuentes
¿Cuándo compensa comprar una GPU?
Cuando la utilización supera el 50-70% del tiempo. Con uso 24×7 a 3 años, DGX Spark (4.800 €) tiene un TCO de ~6.500 € frente a ~126.000 € de una H100 cloud.
¿DGX Spark o RTX 5090?
DGX Spark: 128 GB por 4.800 €, ideal para modelos grandes. RTX 5090: 32 GB VRAM pero mucho mayor throughput, ideal para modelos ≤32B con baja latencia. Capacidad vs velocidad.
¿Cuánto cuesta la electricidad?
A 0,20 €/kWh y 24×7: DGX Spark ~409 €/año, RTX 5090 ~1.314 €/año, RTX PRO 6000 ~1.402 €/año. Es un factor, pero raramente cambia la conclusión frente al cloud.
¿Cuál es la mejor GPU para DeepSeek 70B?
70B Q4 (~50 GB): RTX PRO 6000 (96 GB). 70B FP16 (~150 GB): 2× RTX PRO 6000 (192 GB) o cloud H200. DGX Spark puede cargarlo pero con menor throughput.
Domina la IA aplicada: de Ollama a clusters en producción
Los 3 primeros módulos de IAcademy son gratis. Incluyen prompting avanzado, LLMs locales y automatización con IA.
Empieza gratisCurso completo: 614 módulos de IA aplicada
23 especializaciones por departamento. Dashboard con progreso. Quizzes y skills desbloqueables. Desde 19 EUR.
📚 Aprende más en el curso
Este artículo complementa el Módulo M01: Como funciona la IA. Incluye vídeo, quiz, flashcards con repaso espaciado y proyecto práctico.